
UserPartName
Промокод: RL10
Научим внедрять RL-алгоритмы на практике в играх, робототехнике, энергетике и финансах
Advanced
Онлайн
Reinforcement Learning — это одна из трех основных парадигм машинного обучения, в котором агент учится взаимодействовать с окружающей средой методом проб и ошибок. Reinforcement Learning можно использовать в разных областях:
В играх, чтобы создавать ботов, которые могут победить даже лучших игроков.
В робототехнике, чтобы роботы могли учиться и улучшать свои навыки без постоянного программирования.
В финансах, чтобы создавать алгоритмы, которые могут сами покупать и продавать активы и приносить прибыль.
В электронной коммерции, чтобы создавать системы, которые предлагают товары, которые нравятся покупателям.
В промышленности, чтобы оптимизировать работу заводов и снизить расход энергии.
Понимать, как работает обучение с подкреплением, и применять классические алгоритмы типа Q-learning, SARSA и Monte Carlo.
Создавать модели окружения и обучать агентов RL для решения задач в ваших условиях.
Использовать нейронные сети в RL и применять алгоритмы Deep RL, от самых простых, таких как DeepQ-Network (DQN) до самых сложных, таких как Proximal policy optimization (PPO).
Использовать продвинутые методы RL, такие как оптимальное управление, обучение со скользящим горизонтом и Model-based RL, для сложных задач.
Решать конкретные задачи с помощью RL и понимать, как это работает на практике.
Создавать ботов и NPC для игр, которые будут обучаться и подстраиваться под игрока, делая игру интереснее и неожиданнее.
Делать роботов, которые смогут сами ориентироваться в пространстве, двигать предметы и выполнять задачи в разных условиях.
Создавать алгоритмы, которые будут автоматически торговать на финансовых рынках, анализируя данные и принимая решения о покупке и продаже, чтобы заработать побольше и не рисковать.
Делать персонализированные рекомендации, которые будут учитывать вкусы пользователей и предлагать им подходящие товары, услуги или контент.
Решать разные задачи по оптимизации и управлению в разных сферах: от производства до энергопотребления. RL поможет автоматизировать процессы и сделать их эффективнее.
NOTE! По итогу большинства вебинаров вы получаете Jupyter Notebook с разбором практического кейса по материалам занятий.
Возможность совмещать учебу с работой
Преподаватели из разных сфер, каждый со своим уникальным опытом.
Получите знания, которые помогут повысить вашу востребованность и доход.
Разместите резюме в базе OTUS: так наши партнёры смогут пригласить вас на интервью
Темп обучения: 2 занятия по 2 ак.часа в неделю. Доступ к записям и материалам остается навсегда
Домашние задания с поддержкой и обратной связью наших преподавателей помогут освоить изучаемые технологии.
Чат в Telegram для общения преподавателей и студентов.
Модуль начинается с общего введения, охватывает ключевые особенности обучения с подкреплением, основные алгоритмы. Вы рассмотрите, как построить модель окружения и агента, и примените свои знания на простых сценариях.
Тема 1: Знакомство с Reinforcement Learning
Тема 2: Ключевые понятия RL: агент, среда, награда, политика. Построение среды
Тема 3: Основные алгоритмы RL: Value based
Тема 4: Основные алгоритмы RL: Policy based
В этом модуле вы рассмотрите введение в глубокое обучение с подкреплением, которое объясняет значимость глубоких Q-сетей, представляет алгоритмы на основе политик. Затем объединяет методы на основе политик и значений с использованием алгоритма Actor-Critic. И, наконец, охватывает то, как нейронные сети могут использоваться для аппроксимации функций вознаграждения и политик.
Тема 1: Введение в Deep Reinforcement Learning
Тема 2: Deep Q-Network (DQN) алгоритм
Тема 3: Deep Policy Gradient (PG) алгоритм
Тема 4: Actor-Critic алгоритм
Тема 5: TRPO -> PPO
Тема 6: DDPG -> TD3 -> LSTM-TD3
Модуль содержит более сложные темы и глубже раскрывает пройденный материал. Здесь рассматривается применение алгоритмов к более сложным ситуациям, например наличие фиксированных правил (model-based) или взаимодействие нескольких агентов между собой для достижения общей темы.
Тема 1: Обучение с использованием модели среды (model-based rl)
Тема 2: Model-based, часть 2
Тема 3: Иерархическое обучение с подкреплением
Тема 4: Выбор темы и организация проектной работы
Тема 5: Многоагентное обучение и кооперация агентов
Тема 6: Трансформеры в RL: decision transformers и action transformers
Модуль посвящен обзору практических примеров применения RL. Вы познакомитесь с игровой индустрией и рассмотрите какие задачи здесь можно решать с помощью RL. Поговорите о робототехнике, поймете какое применение RL находит в рекомендательных системах и более подробно рассмотрите финансовые модели на примере задачи балансировки портфеля активов и задачи кредитного скоринга.
Тема 1: Применение RL в игровой индустрии
Тема 2: Применение RL в робототехнике
Тема 3: RL в рекомендательных системах
Тема 4: RL в задаче скоринга
Тема 5: Применение RL в управлении финансовым портфелем
Заключительный месяц курса посвящен проектной работе. Свой проект — это то, над чем интересно поработать слушателю. То, что можно создать на основе знаний, полученных на курсе. При этом не обязательно закончить его за месяц. В процессе написания по проекту можно получить консультации преподавателей.
Тема 1: Консультация по проектам и домашним заданиям
Тема 2: Предзащита
Тема 3: Защита проектных работ. Подведение итогов курса
Последний месяц отводится для проектной работы. Студенты могут выбрать одну из сфер, где будут реализовывать алгоритмы обучения с подкреплением:
Эксперты-практики делятся опытом, разбирают кейсы студентов и дают развернутый фидбэк на домашние задания
OTUS осуществляет лицензированную образовательную деятельность. Вы получите сертификат о прохождении обучения, а также можете получить удостоверение о повышении квалификации.
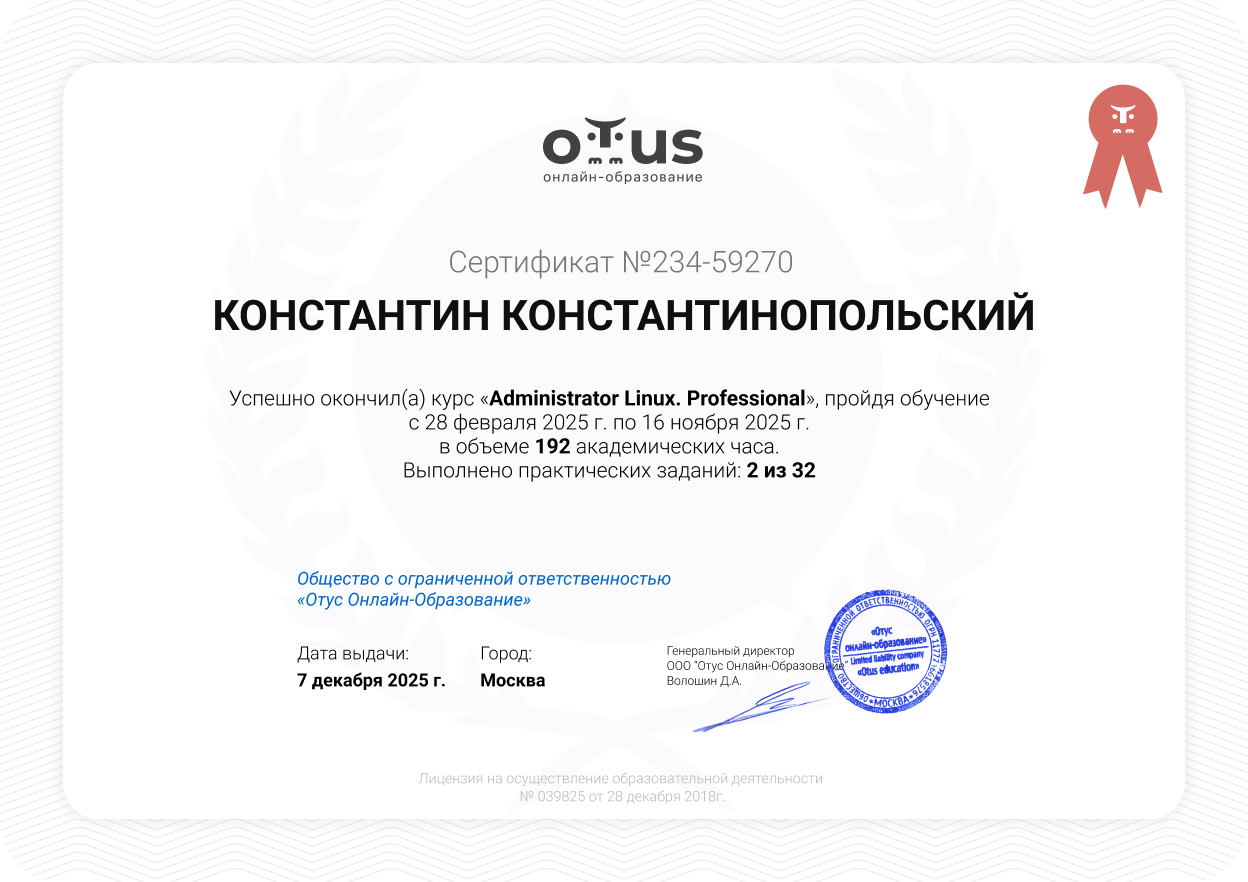

Удостоверение о повышении квалификации: если вы успешно защитили выпускной проект и готовы предоставить копию документа о высшем или среднем профессиональном образовании
Доступ к учебным материалам курса
Ваш личный проект, который поможет проходить собеседования